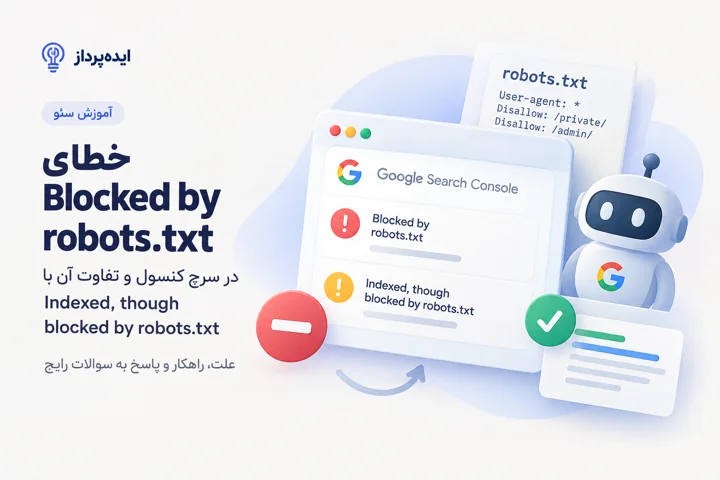
اگر در Google Search Console در گزارش Page Indexing با خطای Blocked by robots.txt مواجه شدهاید، قبل از هر چیز باید مشخص کنید URL موردنظر واقعا نباید توسط گوگل کراول شود یا اینکه این URL بهاشتباه توسط فایل robots.txt مسدود شده است.
نکته مهم این است که robots.txt برای کنترل خزش (Crawl) است، نه حذف یک صفحه از نتایج گوگل. بنابراین دیدن این خطا لزوما به معنی مشکل جدی یا حذف صفحه از ایندکس نیست.
ارور Blocked by robots.txt یعنی چه؟
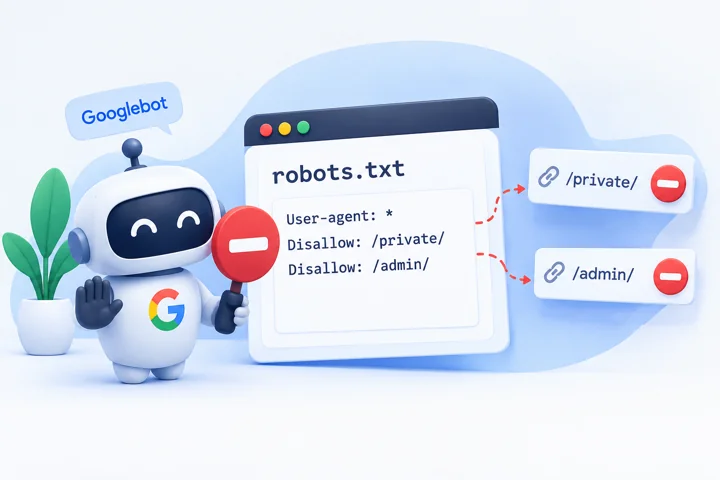
وقتی گوگل میخواهد یک URL را کراول کند، ابتدا فایل robots.txt سایت را بررسی میکند. اگر در این فایل دستوری وجود داشته باشد که دسترسی Googlebot به آن URL را ممنوع کند، گوگل صفحه را کراول نمیکند.
مثلا:
User-agent: *
Disallow: /private/
با این تنظیم، URLهایی مانند زیر برای Googlebot مسدود میشوند:
example.com/private/page/
در سرچ کنسول ممکن است این وضعیت با عنوان Blocked by robots.txt نمایش داده شود. در این حالت گوگل نمیتواند محتوای صفحه را بررسی کند و در نتیجه نمیتواند مواردی مثل متن، تگهای متا، canonical یا noindex را از داخل صفحه بخواند. برای کسب اطلاعات بیشتر، پیشنهاد میکنیم حتما مقاله آموزش سرچ کنسول را مطالعه کنید.
چطور خطای Blocked by robots.txt را برطرف کنیم؟
اگر URL باید در گوگل ایندکس شود، مراحل زیر را انجام دهید.
۱. فایل robots.txt را بررسی کنید
معمولا فایل در این آدرس قرار دارد:
https://example.com/robots.txt
دنبال Disallow مربوط به URL موردنظر بگردید.
مثلا:
User-agent: *
Disallow: /blog/
در این حالت تمام URLهای زیر /blog/ مسدود شدهاند.
گاهی نیز یک دستور بسیار گسترده مانند این باعث مشکل میشود:
User-agent: *
Disallow: /
این دستور عملا خزش کل سایت را برای Googlebot مسدود میکند.
۲. ببینید URL واقعا باید Crawl شود یا نه
قبل از حذف Disallow از خودتان بپرسید:
آیا این صفحه باید در گوگل نمایش داده شود؟
آیا صفحه مهمی برای سایت است؟
آیا مقاله، محصول یا صفحه خدمات است؟
آیا محتوای قابل جستجویی دارد؟
اگر جواب مثبت است، نباید آن URL را در robots.txt مسدود کنید.
۳. قانون اشتباه را حذف یا اصلاح کنید
برای مثال اگر چنین قانونی دارید:
User-agent: *
Disallow: /blog/
و میخواهید مقالات وبلاگ کراول شوند، باید این قانون را اصلاح کنید.
بعد از تغییر، فایل robots.txt جدید را بررسی کنید و مطمئن شوید URL دیگر توسط آن مسدود نمیشود.
۴. URL را در URL Inspection بررسی کنید
در سرچ کنسول، URL موردنظر را در URL Inspection وارد کنید.
این ابزار به شما کمک میکند ببینید گوگل در وضعیت فعلی چه چیزی درباره URL میداند و آیا دسترسی به آن وجود دارد یا خیر. گوگل نیز برای بررسی دسترسی Googlebot و مشکلات خزش، استفاده از URL Inspection را توصیه میکند.
بعد از رفع مشکل میتوانید برای URL درخواست Request Indexing بدهید؛ البته درخواست ایندکس به معنی تضمین ایندکس شدن نیست.
آیا خطای Blocked by robots.tx یک مشکل است؟
نه، همیشه.
این وضعیت زمانی مشکل محسوب میشود که URL موردنظر باید در گوگل ایندکس شود. برای مثال اگر این URL یک صفحه خدمات، محصول یا مقاله مهم سایت است و میخواهید در نتایج گوگل نمایش داده شود، مسدود بودن آن در robots.txt مشکل است.
اما اگر URL مربوط به یک بخش غیرضروری، صفحات فیلتر، پارامترهای خاص یا منابعی باشد که عمدا نمیخواهید گوگل آنها را کراول کند، وجود این وضعیت میتواند کاملا عمدی باشد. گوگل نیز استفاده از robots.txt را برای کنترل خزش صفحات یا منابع غیرضروری توصیه میکند؛ مشکل زمانی ایجاد میشود که از آن بهعنوان ابزار حذف صفحه از نتایج جستجو استفاده شود.
خطای Indexed, though blocked by robots.txt چیست؟
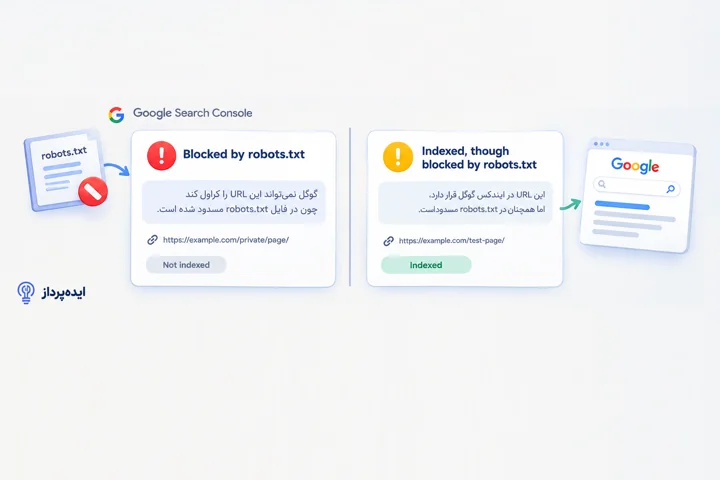
این وضعیت با Blocked by robots.txt تفاوت مهمی دارد.
در حالت:
Blocked by robots.txt
گوگل URL را پیدا کرده، اما به دلیل قانون robots.txt نتوانسته آن را کراول کند و معمولا آن URL را در گزارش صفحات ایندکسنشده قرار میدهد.
اما در حالت:
Indexed, though blocked by robots.txt
گوگل URL را در ایندکس خود دارد، در حالی که همچنان اجازه کراول آن طبق robots.txt داده نشده است.
چطور ممکن است؟
فرض کنید صفحهای دارید:
example.com/test-page/
و در robots.txt نوشتهاید:
User-agent: *
Disallow: /test-page/
اگر گوگل URL را از طریق لینک داخلی، لینک خارجی، sitemap یا منابع دیگر پیدا کرده باشد، ممکن است URL را بدون اینکه بتواند محتوای آن را کراول کند، وارد ایندکس کند.
به همین دلیل ممکن است URL در نتایج جستجو ظاهر شود؛ حتی اگر گوگل نتواند محتوای صفحه را بخواند. گوگل صراحتا اعلام کرده که یک URL مسدودشده در robots.txt همچنان میتواند در صورت پیدا شدن از منابع دیگر، ایندکس شود. به همین دلیل این وضعیت در سرچ کنسول یک هشدار (Warning) است، نه اینکه الزاما به معنی خراب بودن سایت باشد.
مقالات مشابه: خطای Sitemap status: Couldn’t fetch
تفاوت Blocked by robots.txt و Indexed, though blocked
بهصورت ساده
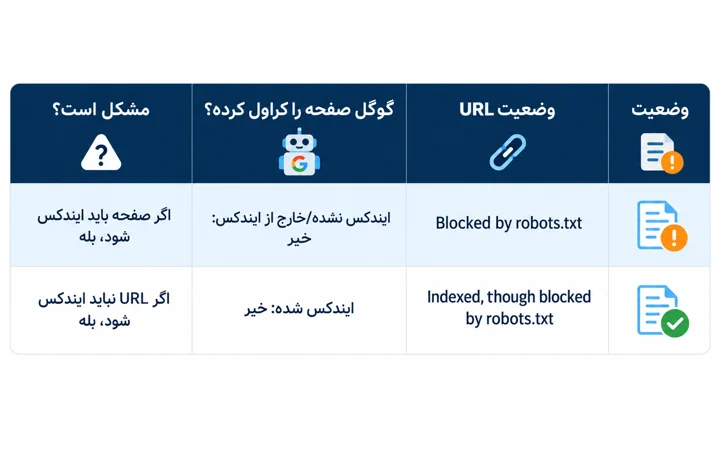
بنابراین مهمترین تفاوت این دو وضعیت ایندکس URL است.
در هر دو حالت، robots.txt مانع کراول صفحه شده؛ اما در حالت دوم گوگل توانسته URL را بدون کراول محتوا وارد ایندکس کند.
آیا Blocked by robots.txt باعث حذف ایندکس میشود؟
خیر، مسدود کردن URL در robots.txt بهخودیخود باعث حذف فوری آن از ایندکس نمیشود.
حتی اگر صفحهای قبلا ایندکس شده باشد و بعد آن را در robots.txt مسدود کنید، گوگل دیگر نمیتواند صفحه را کراول کند تا مثلا متوجه noindex شود. بنابراین URL ممکن است همچنان در نتایج گوگل باقی بماند.
این یکی از رایجترین اشتباهات در استفاده از robots.txt است:
robots.txt برای جلوگیری از Crawl است، نه برای جلوگیری قطعی از Index شدن. اگر هدف شما این است که یک صفحه در نتایج گوگل نمایش داده نشود، روش مناسب معمولا استفاده از noindex است.
اما یک نکته بسیار مهم وجود دارد:
صفحهای که در robots.txt مسدود شده، نمیتواند noindex خود را به گوگل نشان دهد.
بنابراین این ترکیب اشتباه است:
Disallow: /page/
و همزمان:
<meta name=”robots” content=”noindex”>
چون گوگل به دلیل Disallow اصلا نمیتواند صفحه را کراول کند تا noindex را ببیند.
برای حذف صفحه از گوگل چه باید کرد؟
اگر هدف شما حذف صفحه از نتایج گوگل است، صرفا آن را در robots.txt مسدود نکنید.
برای یک صفحه HTML معمولا میتوانید:
دسترسی Googlebot به صفحه را باز کنید.
روی صفحه noindex قرار دهید:
<meta name=”robots” content=”noindex”>
اجازه دهید گوگل صفحه را دوباره کراول کند.
وقتی Googlebot بتواند صفحه را ببیند و noindex را دریافت کند، میتواند آن URL را از نتایج جستجو حذف کند. اگر صفحه حاوی اطلاعات خصوصی است، noindex هم روش مناسبی برای محافظت از اطلاعات نیست؛ در چنین شرایطی باید دسترسی صفحه را با احراز هویت یا روشهای امنیتی مناسب محدود کرد.
چرا بعضی URLها با وجود مسدودیت robots.txt هنوز در گوگل هستند؟
ممکن است گوگل URL را از منابع مختلف پیدا کند؛ مثلا:
لینک داخلی، لینک از سایتهای دیگر، Sitemap، URLهای قدیمی، منابعی که قبلا توسط گوگل شناخته شدهاند
گوگل برای ایندکس کردن یک URL لزوما همیشه نیاز ندارد ابتدا محتوای آن را کراول کند. به همین دلیل مسدود کردن URL در robots.txt تضمین نمیکند که آدرس آن هرگز در نتایج گوگل دیده نشود.
جمعبندی
اگر در سرچ کنسول Blocked by robots.txt میبینید، شما به عنوان یک دیجیتال مارکتر اول بررسی کنید URL باید ایندکس شود یا نه.
- اگر باید ایندکس شود:
قانون Disallow را بررسی و در صورت اشتباه اصلاح کنید.
- اگر نمیخواهید صفحه در گوگل باشد:
بهجای robots.txt از noindex استفاده کنید و اجازه دهید Googlebot صفحه را کراول کند.
- اگر میبینید Indexed, though blocked by robots.txt:
یعنی URL با وجود مسدود بودن در robots.txt، در ایندکس گوگل قرار گرفته است. این وضعیت بهتنهایی به معنی حذف شدن صفحه نیست و اتفاقا نشان میدهد robots.txt ابزار مناسبی برای جلوگیری قطعی از ایندکس نیست.
در یک جمله:
robots.txt میگوید «گوگل این URL را Crawl نکن»، اما noindex میگوید «این URL را در نتایج جستجو قرار نده». برای مطالعه آموزشهای بیشتر در زمینه سئو، تکنولوژی و سایت، حتما سایر مقالات وبسایت ایده پرداز را هم مطالعه کنید.